回头整理毕业研究,最容易写出来的是几个数字:帧时间降了多少,缓存命中率涨了多少。难一点的是把这些数字放回系统里看。少算了一部分画面,用户在意的细节还在吗?缓存复用了更多内容,做决策花的时间又怎么算?
这篇用论文里的几张图,把三个阶段串起来记一下:先调整终端渲染,再做多人缓存复用,最后接成端边协同系统。图表和数字都来自终版论文,这次整理没有重新跑实验。
先把系统摆出来
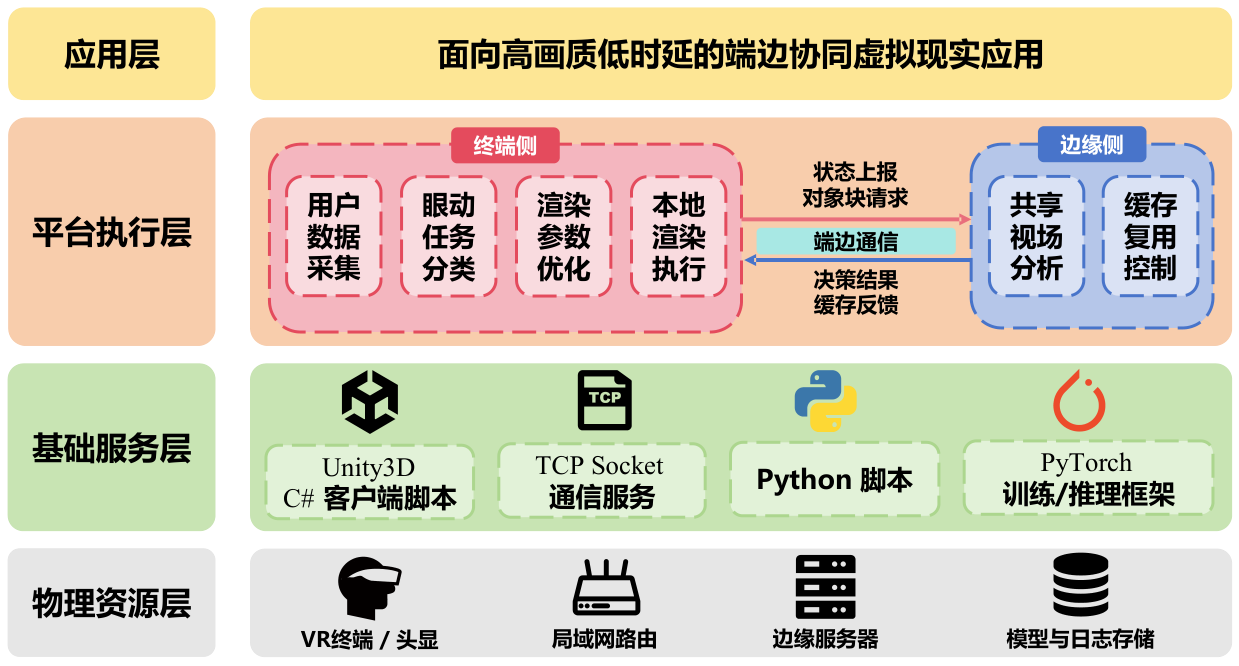
| 位置 | 优化想法 | 需要保住什么 |
|---|---|---|
| 终端侧 | 当前任务不需要的细节少算一点 | 用户关心区域的画质,参数变化的连续性 |
| 边缘侧 | 多人共同使用的对象块尽量复用 | 缓存容量、决策成本和响应节奏 |
| 两端之间 | 状态与决策及时交换 | 通信与处理链路的可观察性 |
前两个阶段分别看方法是否有效,第三个阶段再把行为采集、渲染、缓存和通信接起来。分开做实验时比较清楚,接起来以后还得看各段之间有没有增加新的开销。
都盯着同一个位置,需求也可能不同
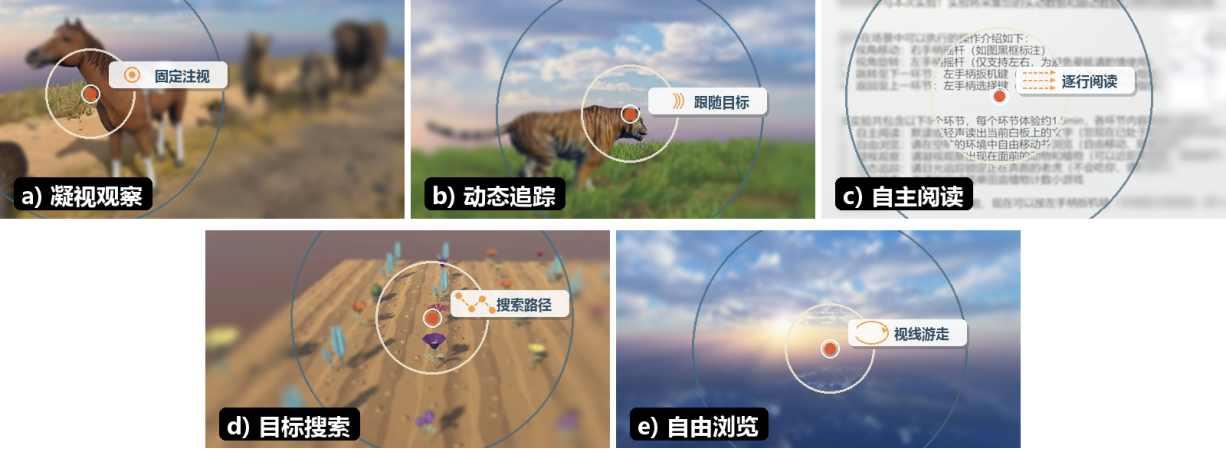
中心凹渲染会给注视中心保留更多细节,外围降低分辨率。我的研究在这个基础上加了一步:根据一段头动和眼动序列识别当前任务,再调整高质量区域、过渡区域和外围质量。
读文字、追踪移动目标、在场景里找东西,都可能看向同一个位置,但需要的细节和覆盖范围不同。这也是我引入任务信息的原因:只知道“看哪里”,还不太够。
| 渲染策略 | 片段平均帧时间 | 平均片段超预算比例 |
|---|---|---|
| 全分辨率 | 10.14 ± 2.99 ms | 33.42% |
| TAFR | 5.40 ± 2.97 ms | 4.81% |
表 3.7 里,按场景—路径片段统计后,TAFR 的片段平均帧时间从 10.14 ms 降到了 5.40 ms,相对全分辨率的加速比是 1.88×。
这里我只把它写成渲染实验的收益。整套 VR 系统还有通信和边缘处理,不能把 1.88× 直接放到端到端响应上。画质也要回到具体场景和图像指标里看,单看帧时间还不够。
命中率涨了,还得看决策花了多久
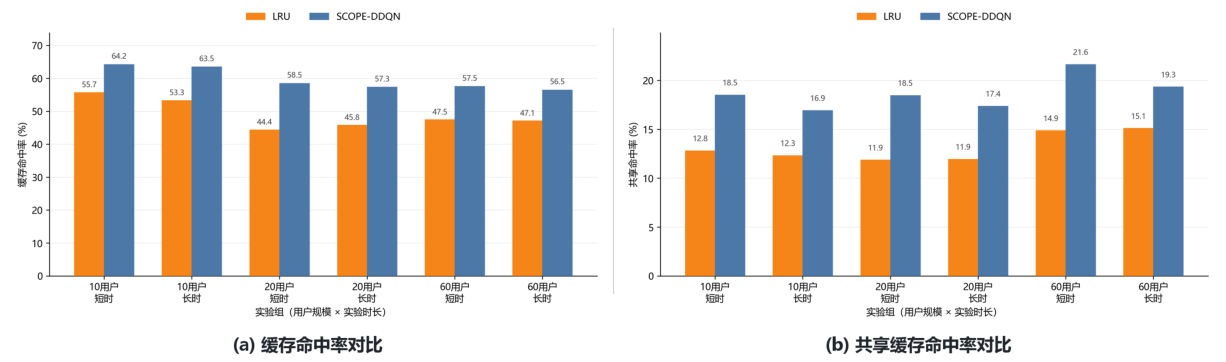
多人需要同一批对象块时,复用缓存可以省掉重复处理。不过,共享关系识别、用户分组、策略推理和缓存更新也需要时间。我会把命中率和处理耗时放在一起看。
| 指标 | 它能说明什么 | 它不能独自说明什么 |
|---|---|---|
| 缓存命中率 | 当前请求中已有内容被复用的程度 | 画面质量和完整用户响应时间 |
| 共享命中率 | 跨用户共享内容的复用情况 | 对所有新用户和新场景都有效 |
| 边缘处理代理时延 | 请求进入边缘服务到响应生成的耗时 | 网络往返和头显 Motion-to-Photon 时延 |
第五章六个成对条件里,SCOPE-DDQN 相对 LRU 的缓存命中率平均相对增益是 22.08%,共享命中率是 42.78%。整理这些数时,我会把“相对增益”几个字一起保留,否则很容易被读成增加了多少个百分点。
拿 20 用户短时实验算一遍就比较直观:44.37% 到 58.47%,相差 14.10 个百分点;除以前面的 44.37%,相对增益才是约 31.78%。六个条件的 22.08% 则是各条件相对增益的平均值。
连续跑 30 分钟,再看这张图
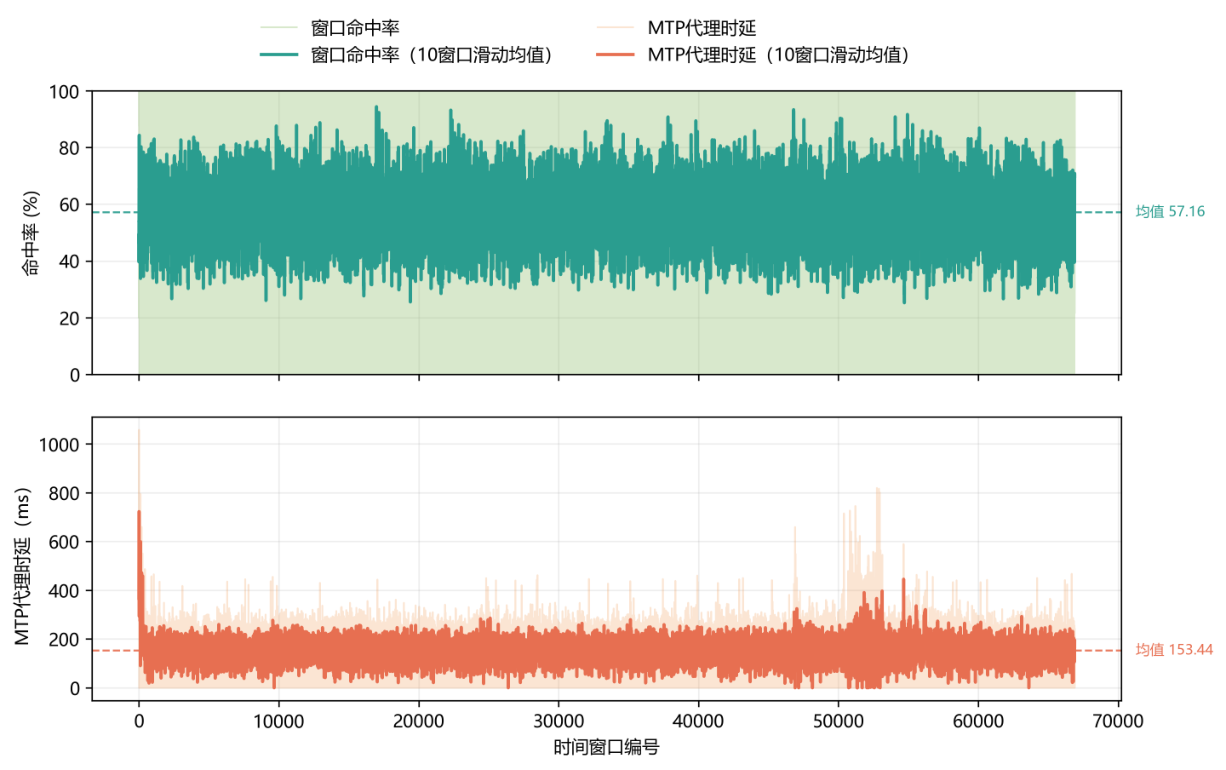
这组是 60 用户仿真请求负载,连续运行 30 分钟。图里的窗口级命中率均值是 57.16%,边缘处理代理时延均值约 153.44 ms。读图时,有三个地方要和数字一起看:
- 横轴是时间窗口编号,不能直接读成秒或毫秒。
- 代理时延不是完整头显端到端时延。
- 60 用户指可控仿真请求负载;真实头显接入验证的是行为采集、渲染与通信链路,并不代表 60 位真人同时戴头显体验。
下一次做实验,我还想多看几项
| 如果追求这个目标 | 同时检查这个代价 |
|---|---|
| 更高画质 | 渲染开销是否超出预算 |
| 更高复用率 | 群组识别和策略决策是否增加处理成本 |
| 更快响应 | 是否降低了用户真正需要的画面质量 |
| 更稳定的均值 | 高分位表现、窗口波动与不同用户是否均衡 |
均值之外,我还想继续看高分位、窗口波动和不同用户之间的差异。有些开销是在集成后才出现的,分开测试方法时不容易看到。
以后再写“优化了多少”,我会把对应环节和实验条件一起写上。省掉这两句,数字看着更漂亮,却也更难判断到底改好了什么。